


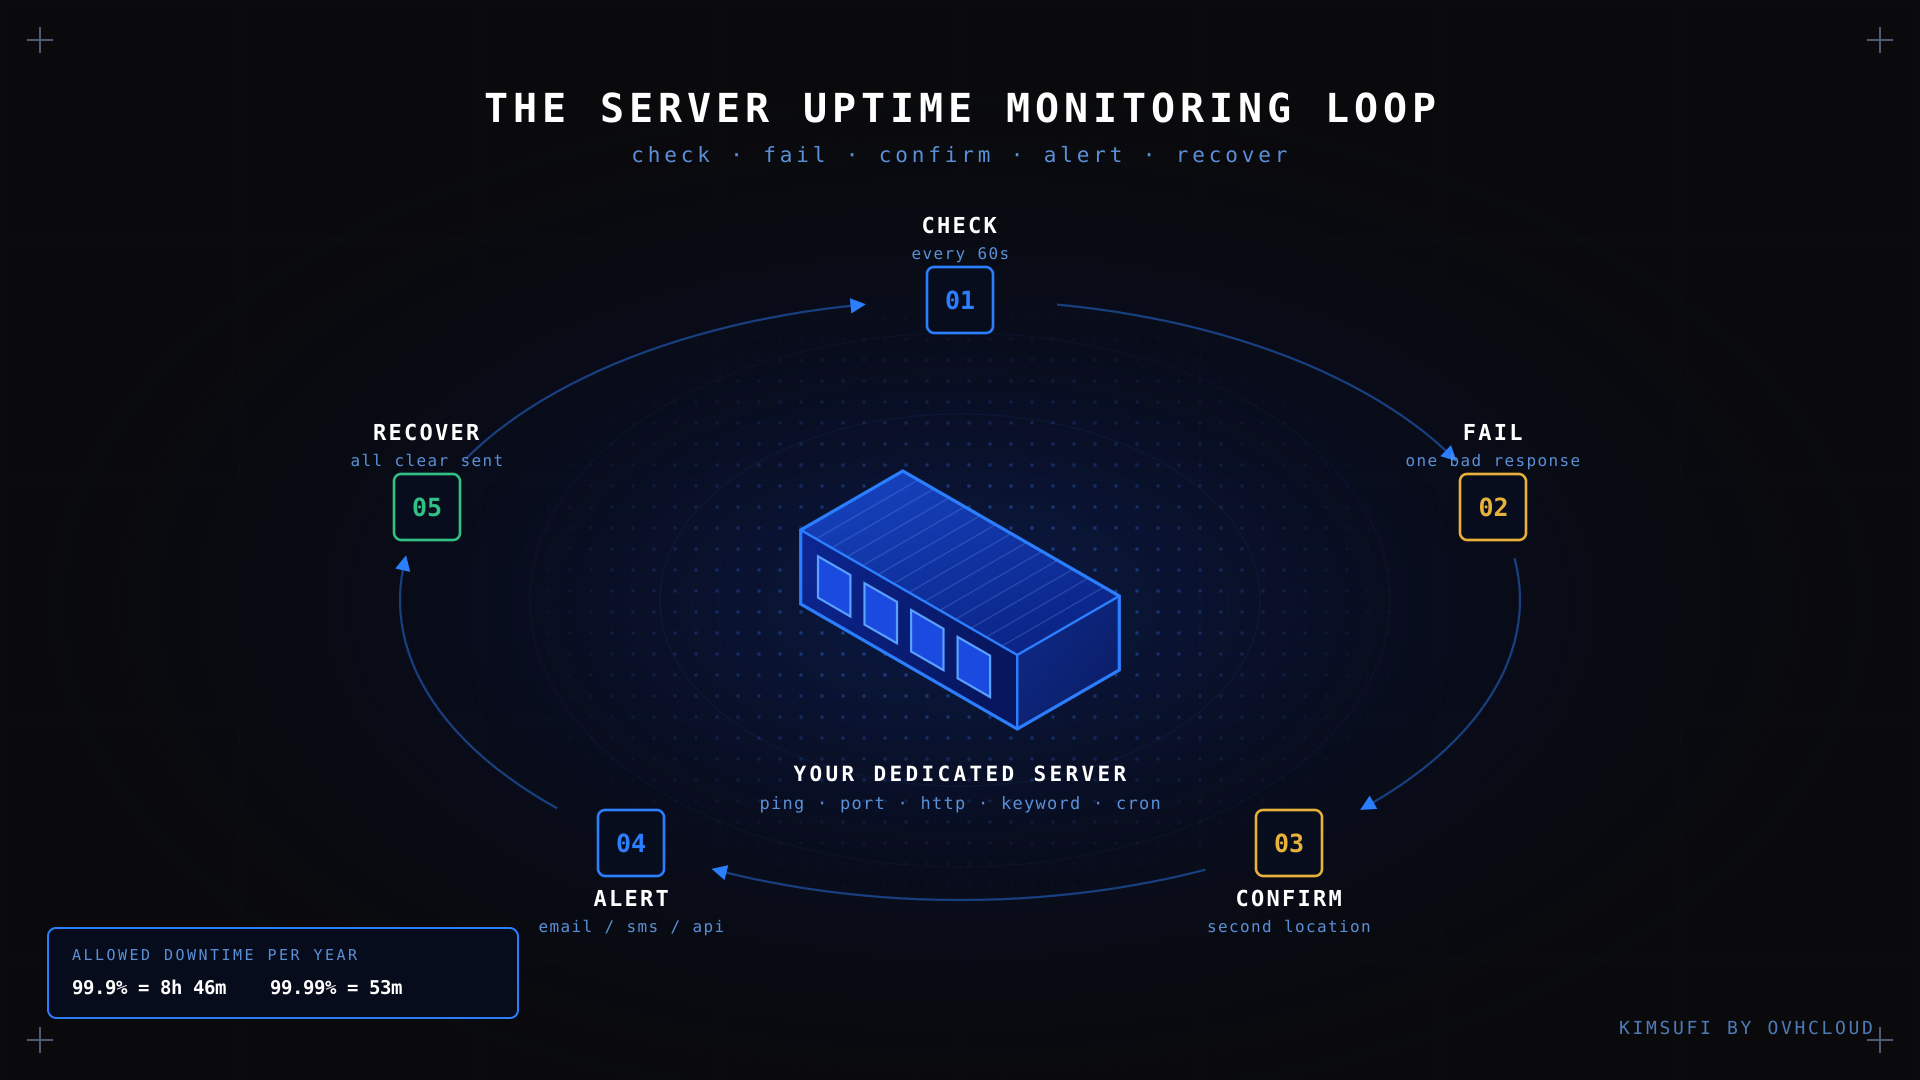
L'uptime d'un serveur est la part de temps pendant laquelle votre machine reste joignable et fonctionnelle, et surveiller l'uptime d'un serveur signifie le tester automatiquement : vous entendez parler d'une panne avant vos utilisateurs. Une heure d'indisponibilité coûte de l'argent réel, pourtant avant vos utilisateurs. Une heure d'indisponibilité coûte de l'argent réel, pourtant bien des petites équipes l'apprennent par accident. Ce guide couvre les cinq méthodes, les alertes qui vous rejoignent, et ce que nous faisons tourner chaque jour sur des serveurs dédiés.
À retenir
- Un monitor d'uptime serveur teste votre machine à intervalle fixe, généralement toutes les 60 secondes à 5 minutes, et vous alerte quand un test échoue.
- Les cinq types de moniteur sont ping, port, HTTP(S), mot-clé et cron. Chacun détecte une panne différente.
- Les alertes de monitor doivent arriver là où vous regardez : email, SMS, Slack, PagerDuty ou un webhook.
- Une page de statut publique et un dashboard transforment l'indisponibilité en communication transparente, pas en boîte mail inondée.
- Sur un serveur dédié, les contrôles de disponibilité couvrent aussi le hardware : disque, charge et santé réseau.
Qu'est-ce que l'uptime d'un serveur (et pourquoi le surveiller) ?
L'uptime serveur est le pourcentage de temps pendant lequel un serveur est sous tension, joignable et répond correctement aux requêtes. On le mesure mensuellement ou annuellement : 99,9 % autorise un peu moins de neuf heures d'indisponibilité par an. Cette figure mélange deux choses : la disponibilité demande si la machine répond du tout, la performance demande à quelle vitesse.
Le coût est ce qui rend l'automatisation rentable. Dans l'Annual Outage Analysis 2026 de l'Uptime Institute, 57 % des opérateurs sondés disent que leur dernière panne majeure a dépassé 100 000 $. Ce sont des chiffres de datacentres, mais la direction est juste.
Comment fonctionne un monitor d'uptime serveur ?
Un monitor d'uptime serveur fait tourner un processus en boucle. Un agent contacte votre endpoint selon un plan et compare la réponse à un seuil que vous avez fixé. Un seul échec rarement signifie une panne, donc un bon service cloud-hébergé confirme depuis un second point avant de réveiller qui que ce soit. Ce processus de confirmation sépare un outil utile d'un outil bruyant.
Une fois confirmé, les alertes partent et le test continue jusqu'à ce que le processus de rétablissement soit terminé. Ensuite, le cycle se répète. Mettez les contrôles en pause pendant une maintenance planifiée, et tenez un calendrier de maintenance pour qu'un reboot ne déclenche jamais une escalade à 3 heures du matin.
Les 5 méthodes de surveillance comparées
Chaque type de monitor attrape ce que les autres ratent : un seul test suffit rarement.
Ping
Envoie un ICMP echo request et attend une réponse. Prouve que l'hôte est sous tension et routable, rien de plus, et tombe en premier lors d'un incident réseau.
Port
Ouvre une connexion TCP vers un service : 22 pour SSH, 3306 pour MySQL, 25565 pour un serveur de jeu. Attrape le cas où la machine va bien mais que le daemon est mort.
HTTP(S)
Requête une URL et inspecte le code d'état et le temps de réponse. Le proxy le plus proche de ce que voit un visiteur, attrape les erreurs 500 et les pages lentes que l'ICMP ne verra jamais.
Keyword
Charge une page et cherche une chaîne attendue. Une application cassée retourne souvent 200 avec une page d'erreur : si « Ajouter au panier » disparaît, quelque chose cloche.
Cron job
Inverse le modèle : votre tâche planifiée appelle une URL quand elle finit, et et une alerte se déclenche si cet appel n'arrive jamais. La seule méthode qui attrape une sauvegarde arrêtée en silence.
| Méthode | Détecte | Intervalle | Idéal pour |
|---|---|---|---|
| Ping (ICMP) | Hôte down, perte de paquets | 1 min | Accessibilité réseau |
| Port (TCP) | Service à l'écoute absent | 1 min | SSH, bases de données, game servers |
| HTTP(S) | Codes d'erreur, faiblesse de performance | 1 min | Sites Web et APIs |
| Keyword | Bon code, mauvais contenu | 5 min | Pages dynamiques, panier d'achat |
| Cron (heartbeat) | Un job qui n'a jamais tourné | Planning du job | Backups, batch |
Comment surveiller l'uptime d'un serveur en 5 étapes
- Choisissez endpoints et type de monitor. Commencez par l'URL publique et le port qui importe le plus. Deux tests bien pensés valent mieux que vingt tests bruyants.
- Réglez l'intervalle. 60 secondes pour ce qui fait face aux clients, 5 minutes pour outils internes.
- Configurez le seuil. Exigez deux ou trois tests consécutifs en échec, et ajoutez un plafond de temps de réponse pour repérer la dégradation avant qu'elle ne s'installe.
- Connectez vos canaux. Faites pointer le monitor vers l'email plus un canal que vous ne pouvez pas ignorer, puis activez l'escalade.
- Publiez une status page. Elle réduit le volume de support et évite que les clients devinent.
Alertes et intégrations : être notifié là où vous travaillez
Une alerte que personne ne lit n'est pas une alerte. L'email est la base, donc ajoutez le SMS pour les heures creuses et Slack pour tenir l'équipe dans un même thread. PagerDuty ajoute rotations et acknowledgements sur un même dashboard, pour qu'un incident ne reste jamais sans propriétaire. Un webhook pousse les événements dans votre propre dashboard.
Deux façons de resserrer le processus et de réduire les fausses alertes. Activez la confirmation multi-locations, pour qu'une mauvaise route ne déclenche pas une alarme. Séparez aussi les tests synthétiques des données utilisateurs réels : les premiers tournent depuis une région cloud de votre choix, les données utilisateurs réels reflètent ce que les visiteurs vivent. Les deux ensemble donnent un signal propre et un contexte honnête.
SLA d'uptime serveur expliqués : 99,9 % vs 99,999 %
Chaque neuf en plus coûte de l'ingénierie. L'arithmétique derrière les cibles de disponibilité courantes :
| Uptime serveur | Indisponibilité annuelle admissible | Par mois |
|---|---|---|
| 99 % | 3 jours 15 heures | 7 h 12 min |
| 99,9 % | 8 h 46 min | 43 min |
| 99,95 % | 4 h 23 min | 22 min |
| 99,99 % | 53 min | 4 min 19 s |
| 99,999% | 5 min 15 s | 26 s |
Le SLA d'un cloud ou d'un hébergeur couvre sa propre couche : alimentation, réseau et matériel. Il ne couvre pas votre application, votre certificat ni votre disque. Combler cet écart est votre travail, et un serveur dédié que vous contrôlez totalement signifie posséder la partie logiciel de la disponibilité.
Dépannage des scénarios d'indisponibilité courants
| Symptôme | Cause probable | Premier réflexe |
|---|---|---|
| L'hôte répond, le test port échoue | Service crashé ou abandonné | Redémarrez l'unité, lisez son journal |
| HTTP 500 après une mise en production | Mauvaise release ou migration inachevée | Revenez en arrière, puis lisez les logs applicatifs |
| Lent, puis injoignable | Disque plein ou processus fou | Libérez du disque, activez la rotation des logs |
| Joignable depuis une région seulement | Routage ou filtrage IP | Retestez depuis une deuxième région |
| Alertes navigateur soudaines | Certificat TLS expiré | Renouvelez, puis automatisez le renouvellement |
Un disque plein est le tueur d'uptime le plus courant. Notre guide sur comment préserver un serveur des interruptions décrit la routine qui l'entoure.
FAQ
Comment vérifier l'uptime de mon serveur ?
Exécutez uptime ou who -b en SSH pour voir depuis combien de temps la machine tourne. Ça ne dit rien de la joignabilité utilisateur : couplez-le avec un service qui surveille l'uptime du serveur depuis l'extérieur de votre réseau.
Que signifie un uptime de 99,999 % ?
Environ cinq minutes d'indisponibilité par an, soit 26 secondes par mois. L'atteindre réclame du matériel redondant, un failover automatique et une équipe d'astreinte : le prix est calibré pour l'infrastructure critique.
Puis-je définir des seuils d'alerte personnalisés ?
Oui. La plupart des outils laissent définir combien d'échecs consécutifs déclenchent une notification, combien de temps attendre entre deux tests, et quel temps de réponse compte comme dégradé. Deux ou trois échecs forment un défaut raisonnable.
Comment fonctionnent les webhooks avec les alertes d'uptime ?
C'est une URL que vous possédez. Quand une alerte se déclenche, le service envoie un POST HTTP avec les détails de l'incident, et votre endpoint décide de la suite : ouvrir un ticket ou déclencher un redémarrage.
Existe-t-il une offre gratuite pour la supervision d'uptime serveur ?
La plupart des services cloud en proposent un, typiquement 50 tests à 5 minutes d'intervalle avec alertes email. Les plans gratuits abandonnent souvent SMS, tests rapides et tableaux de bord de statut.
Conclusion
Une bonne surveillance d'uptime serveur, c'est quelques tests bien choisis, des seuils qui étouffent le bruit, et des alertes acheminées là où vous les verrez. Configurez une fois pour toutes, et l'uptime serveur cesse d'être une devinette.
Cherchez un serveur fiable à surveiller ? Comparez les plans serveurs Kimsufi, à partir de 11,10 $/mois, avec accès root, bande passante non plafonnée et protection DDoS incluse.