






Un serveur de base de données stocke les données de votre application dans des tables ou des documents et répond à ses requêtes. Ce comparatif couvre les plateformes gérées et les solutions auto-hébergées qui méritent une place dans votre liste en 2026, de PostgreSQL et MariaDB à MongoDB, et la façon de choisir selon l'échelle dont vous avez besoin.
Points clés à retenir
- PostgreSQL 18 est le choix par défaut le plus solide pour une nouvelle application. Son I/O asynchrone donne des lectures de stockage jusqu'à 3 fois plus rapides.
- Choisissez d'abord le modèle de données. Un schéma fixe en tables pointe vers PostgreSQL, MySQL ou MariaDB ; une structure variée pointe vers MongoDB.
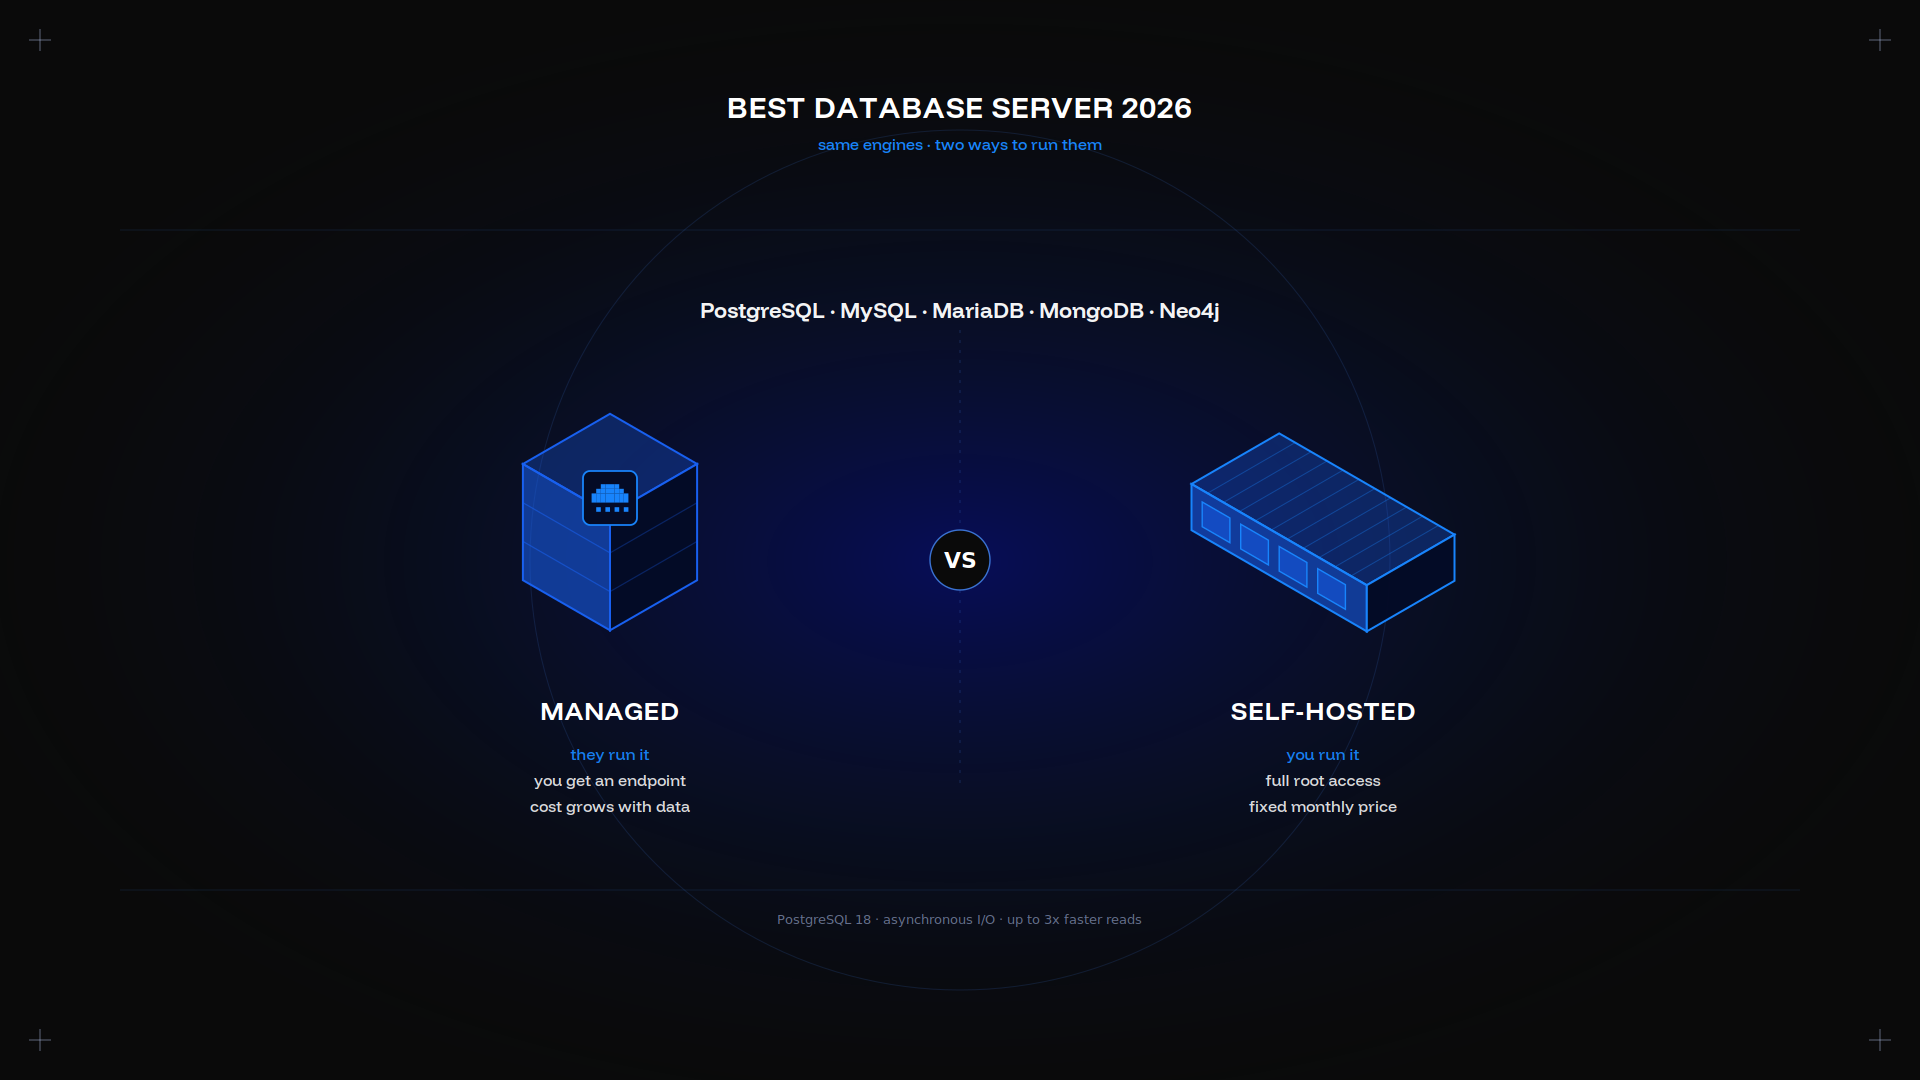
- Géré signifie que vous louez l'exploitation et le support. Auto-hébergé signifie que vous les possédez, et la facture cesse de grandir avec vos données.
- La licence décide plus que la performance : PostgreSQL est permissive, MySQL est GPL, et le distribuer a des conséquences.
- Pour une base de données qui sert une seule application, un serveur dédié bat toutes les offres gérées sur le prix par gigaoctet.
Toutes les options ci-dessous font tourner les mêmes moteurs open source. Ce qui change entre une plateforme gérée et votre propre machine, c'est qui gère le cluster, les sauvegardes et les mises à niveau, et ce que la solution coûte quand vous montez en charge.
Qu'est-ce qu'un serveur de base de données ?
Deux choses portent ce nom. Le logiciel, c'est-à-dire PostgreSQL, MySQL ou MongoDB. Et la machine sur laquelle il tourne, avec son CPU, sa mémoire et son stockage. Les deux comptent, et la plupart des comparatifs de bases de données ne parlent que du premier.
La distinction est pratique. Un serveur de base de données répond aux requêtes d'une application via une connexion, conserve la structure des données sur disque sous forme de tables ou de documents, et la garde cohérente pendant que plusieurs clients écrivent en même temps. Il sert toutes les applications qui en dépendent, donc ses performances sont les leurs. Que cette machine soit une machine louée à nu ou une machine opérée pour vous par un fournisseur est une décision séparée du choix du moteur de base de données.
Relationnel, document, graphe
Trois familles d'architecture couvrent presque tous les déploiements. Une base relationnelle stocke des lignes dans des tables avec un schéma fixe et garantit les transactions, ce dont la plupart des applications métier ont besoin. Une base NoSQL document stocke des enregistrements dont la structure peut varier de l'un à l'autre, ce qui convient à une application dont le modèle de données bouge encore. Une base NoSQL monte en charge sur plusieurs nœuds plus facilement qu'un relationnel. Une base graphe stocke les relations comme des objets de premier rang.
L'architecture choisie contraint tout ce qui suit : comment la base monte en charge, quels outils lui sont compatibles, quelles performances sont atteignables, et combien coûte la migration si vous changez d'avis. Notre page serveur de base de données dédié couvre le côté matériel.
Critères clés pour choisir un serveur de base de données
Six choses décident, à peu près dans cet ordre.
Modèle de données. Relationnel pour des données structurées avec un schéma fixe et des transactions. Document pour une structure variée. Graphe pour des relations. Choisissez le modèle avant le produit, parce que c'est la seule décision qu'une migration ultérieure ne peut pas défaire à moindre coût.
Forme des requêtes. Une charge transactionnelle a besoin d'écritures à faible latence et d'une cohérence forte. L'analytique doit balayer de grands volumes de données. Une base analytique et une base OLTP sont deux choses différentes, et un même serveur de base de données sert rarement bien les deux.
Voie de montée en charge. La montée en charge verticale signifie une machine plus grosse. La montée en charge horizontale signifie plusieurs nœuds avec des répliques ou du sharding pour répartir la charge. Sachez quelle voie il vous faut avant d'y être forcé.
Charge opérationnelle. Sauvegardes, failover, mises à niveau, configuration et supervision. Vous les faites ou vous payez quelqu'un. Un déploiement robuste a besoin des cinq, quelle que soit la base de données.
Licence. Open source n'est pas une seule licence, et les différences mordent au moment de distribuer. Vérifiez-la avant de vous engager sur une base de données.
Prix total. Pas l'offre mensuelle, mais l'offre plus le stockage plus le trafic sortant plus votre temps.
Posez ces éléments en liste d'exigences avant de comparer les produits de bases de données. La plupart des équipes choisissent une base par habitude, puis découvrent l'exigence manquée, généralement la montée en charge ou une contrainte de licence.
Top 5 des serveurs de bases de données gérés
Géré signifie que le fournisseur opère le déploiement, applique les correctifs et gère le failover. Vous recevez un endpoint et une facture.
Amazon RDS sert PostgreSQL, MySQL et SQL Server avec sauvegarde automatisée, reprise multi-AZ et répliques de lecture. Le choix par défaut quand vous êtes déjà sur AWS.
Google Cloud SQL sert les mêmes moteurs avec haute disponibilité et bascule de maintenance en moins d'une seconde. Intégration forte au reste de la plateforme.
MongoDB Atlas est l'option document gérée, avec sharding natif, cohérence configurable et un écosystème mature. C'est la référence pour les applications à schéma souple.
Azure Database for PostgreSQL compte si votre organisation est déjà chez Microsoft, avec une intégration d'annuaire qui épargne un vrai travail et une bonne compatibilité avec l'outillage existant.
Neon et PlanetScale représentent l'alternative serverless plus récente : branching, passage à zéro et facturation à la requête, pensés pour les workflows de développement plutôt que pour une charge de production régulière. Utiles comme base de développement, moins comme base de production.
Chaque plateforme gère le même ensemble opérationnel : sauvegarde automatisée, une réplique pour le trafic de lecture, patching et supervision. Elles diffèrent par les moteurs servis, la façon dont la réplique est facturée et ce que coûte le trafic sortant quand vous retirez vos données. Comparez ces trois points avant les tableaux de fonctionnalités.
MongoDB Atlas mérite un examen plus approfondi, parce que c'est la plateforme la plus souvent présélectionnée pour les charges document. Atlas tourne par défaut sur un replica set, si bien qu'un déploiement Atlas compte trois nœuds plutôt qu'un, et l'offre choisie fixe la mémoire et le stockage de chaque nœud. Atlas gère sharding, sauvegarde et failover, et l'offre gratuite d'Atlas est vraiment utile en développement. Le hic est le même que pour toute plateforme gérée : un cluster Atlas coûte plusieurs fois ce que coûte le même travail sur du matériel que vous louez, et l'écart se creuse avec vos données.
L'échange. Le géré retire la charge opérationnelle et ajoute un multiplicateur au coût. Ce multiplicateur se justifie quand votre équipe est petite et vos données peu volumineuses, et il est difficile à justifier dans le cas inverse.
Top 5 des serveurs de bases de données auto-hébergés
PostgreSQL est la base open source généraliste la plus solide en 2026. La version 18 a ajouté un sous-système d'I/O asynchrone avec des lectures de stockage jusqu'à 3 fois plus rapides, des skip scans sur index multicolonnes, uuidv7() pour des clés ordonnées dans le temps et des statistiques de planificateur qui survivent à une mise à niveau majeure. Son support JSON est assez bon pour que beaucoup d'équipes n'aient plus besoin d'une base document séparée à côté.
MySQL reste le moteur relationnel le plus distribué, désormais en 9.7 LTS. Réplication mature, écosystème d'outils immense, et le moteur que la plupart des panneaux d'hébergement supposent. À noter : le masquage et les stored programs JavaScript ne se trouvent que dans l'édition commerciale Enterprise.
MariaDB, fork de MySQL né de la gouvernance Oracle, a divergé depuis. La version 12.3 est en cours, et la 11.8 LTS a apporté la recherche vectorielle native, qui retire le besoin d'une extension séparée sur les charges proches de l'IA. Sa compatibilité MySQL reste son principal argument de vente.
MongoDB Community vous donne le même modèle NoSQL document sur votre propre matériel, avec des replica sets pour la disponibilité et du sharding pour répartir les données entre les nœuds.
Neo4j est l'option graphe. Quand vos requêtes parlent de relations plutôt que de lignes, Neo4j répond en une seule traversée à ce qu'un schéma relationnel atteint en plusieurs joins. C'est le produit le plus étroit de cette liste, et le bon pour une forme de problème précise.
Les cinq sont des serveurs de bases de données open source que vous pouvez déployer sur votre propre machine. C'est la vraie alternative à une offre gérée : la même base open source, la même topologie de répliques, sur du matériel dont le prix ne bouge pas avec vos données. Pour la plupart des équipes, cette alternative est la solution la moins chère, et de loin.
Comparaison performances et montée en charge
| Moteur | Modèle | Voie de montée en charge | Fort sur |
|---|---|---|---|
| PostgreSQL | Relationnel | Vertical, répliques de lecture | Charges mixtes, requêtes complexes |
| MySQL | Relationnel | Vertical, répliques | Applications web à forte lecture |
| MariaDB | Relationnel | Vertical, répliques, Galera | Forte lecture, recherche vectorielle |
| MongoDB | Document | Montée en charge horizontale, sharding | Structure variée, fort volume d'écritures |
| Neo4j | Graphe | Vertical, cluster causal | Requêtes sur les relations |
Deux mises en garde honnêtes. Les benchmarks de performance publiés survivent rarement au contact de vos données, donc traitez toute affirmation en pourcentage comme une hypothèse à comparer à votre propre dataset. La performance d'une base de données est spécifique à la charge. Et sur une seule machine, le stockage décide plus que le moteur : notre guide options de stockage couvre les endroits où le NVMe change les chiffres, et la mémoire compte encore plus, ce qu'explique notre guide RAM serveur.
La montée en charge horizontale est la vraie ligne de partage. MongoDB shard nativement sur plusieurs nœuds. PostgreSQL et MySQL montent les lectures avec une réplique et les écritures avec une machine plus grosse, jusqu'à l'ajout d'une couche de sharding externe. Si vous savez que vous dépasserez un nœud, prenez cette exigence de scalabilité en compte dès maintenant, plutôt que pendant un incident.
En pratique, la plupart des applications n'ont jamais besoin de montée en charge horizontale. Un seul serveur de base de données bien dimensionné avec une réplique sert une charge bien plus grande que ce que les équipes attendent, et c'est bien plus simple à opérer qu'un cluster multi-nœuds. Une scalabilité que vous n'utilisez pas est de la complexité que vous payez. Mesurez votre vrai plafond de performance avant de construire pour une échelle que vous n'avez pas.
Vue d'ensemble des prix et des licences
La licence, c'est là où l'open source cesse d'être une seule chose.
PostgreSQL utilise la licence PostgreSQL, permissive et proche de BSD ou MIT. Vous pouvez l'intégrer et la distribuer sans obligation.
MySQL Community est GPL. Distribuer MySQL dans votre propre logiciel vous oblige à fournir votre source sous une licence compatible GPL, sauf à acheter une licence commerciale à Oracle. Ce seul fait explique une bonne partie des migrations vers PostgreSQL.
MariaDB est GPLv2, avec des bibliothèques clientes LGPL, ce qui est plus souple pour les liaisons au code.
MongoDB Community utilise la SSPL, qui n'est pas approuvée par l'OSI et a des conséquences si vous proposez la base comme service.
Côté argent, le schéma est constant chez tous les fournisseurs gérés : vous payez l'offre, puis le stockage, puis le transfert. Une base auto-hébergée sur un serveur dédié coûte un montant fixe par mois quel que soit ce que vous stockez, ce qui est la même comparaison location-propriété que notre guide serveur dédié et cloud, et nos serveurs dédiés à petit budget montrent ce que coûte le matériel.
Sécurité, sauvegarde et haute disponibilité
Accès. Attachez la base à un réseau privé ou à localhost, jamais à toutes les interfaces. Un utilisateur applicatif par application, avec seulement les privilèges dont cette application a besoin.
Chiffrement. TLS sur la connexion, et chiffrement au repos sur le volume. Les fournisseurs gérés font les deux par défaut ; l'auto-hébergé signifie une étape de configuration pour chacun, faite une fois.
Sauvegarde. Un dump nocturne plus un shipping continu des journaux donne un point de restauration mesuré en minutes. Testez la restauration chaque trimestre pour vous assurer qu'elle fonctionne, parce qu'une sauvegarde que personne n'a restaurée est une hypothèse.
Haute disponibilité. Une réplique en réplication en flux vous donne un standby tiède et un second endpoint pour servir les lectures. La promotion automatique demande un manager tel que Patroni pour PostgreSQL ou Galera pour MariaDB. Les plateformes gérées l'incluent ; sur votre propre matériel, c'est une construction délibérée.
Deux machines dans des racks différents avec une réplique entre elles couvrent plus de modes de panne que la plupart des équipes ne l'attendent, et coûtent bien moins cher qu'une offre gérée de haute disponibilité. La configuration est un geste ponctuel délibéré ; ensuite, ça tourne.
Un montage de base de données robuste garantit trois choses : les données chiffrées en transit et au repos, une réplique prête à servir si le primaire tombe, et une sauvegarde stockée quelque part que le primaire ne peut pas atteindre. Les plateformes gérées garantissent les trois par défaut et le facturent. En auto-hébergé, vous configurez chacun une fois.
Intégration et écosystème
L'écosystème est le critère que les équipes sous-estiment, puis regrettent.
Drivers et ORM. PostgreSQL et MySQL ont un support de premier rang dans chaque langage et chaque framework, et un driver compatible avec ce que votre application est écrite. MongoDB est bien servi. Neo4j est plus étroit, et cette étroitesse se voit au recrutement.
Outillage. Migrations, diff de schémas, exporters de supervision, poolers de connexion. PostgreSQL a PgBouncer et un écosystème d'extensions profond ; MySQL a ProxySQL et des décennies d'outillage opérationnel. Chacun de ces outils, vous le voudrez d'ici le troisième mois.
Compatibilité. MariaDB garde une large compatibilité MySQL, si bien que la plupart des applications migrent sans changement de code. Les deux ont assez divergé pour que la compatibilité doive être testée plutôt que supposée, en particulier autour des fonctions JSON et de l'optimiseur.
Recrutement et documentation. La forme de support fournisseur la plus sous-estimée est le nombre de personnes qui connaissent déjà le produit.
C'est là que les produits alternatifs perdent. Un serveur de base de données de niche peut être techniquement meilleur pour votre charge et rester le mauvais choix, parce que l'outil dont vous avez besoin à 3 h du matin n'existe pas, et la personne qui l'a déjà débogué non plus. Pesez le support de l'écosystème comme un vrai critère, pas comme un départage.
Recommandation finale et guide par cas d'usage
Une nouvelle application web, sans contrainte forte : PostgreSQL. Le choix par défaut idéal en 2026, licence permissive, et un support JSON assez bon pour repousser une seconde base de données.
Un site à forte lecture sur une pile LAMP existante : MySQL ou MariaDB. Choisissez le fork si vous voulez la recherche vectorielle ou si la position d'Oracle sur les licences vous déplaît ; sa compatibilité fait que l'application le remarque rarement.
Structure documentaire variée ou évolutive : MongoDB. Atlas si vous le voulez géré, Community si vous le voulez sur votre propre matériel. Atlas est le point de départ idéal quand personne dans l'équipe ne veut opérer un replica set, et Atlas monte ensuite en production.
Requêtes centrées sur les relations : Neo4j, en acceptant un écosystème plus étroit et moins d'outils autour.
L'analytique sur de grands volumes de données : un entrepôt de données, pas une base OLTP. Redshift, BigQuery et Snowflake sont la catégorie, et chacun est séparé de tout ce qui précède. Faire tourner l'analytique sur votre base transactionnelle est l'erreur d'architecture la plus courante ici.
Petite équipe, beaucoup de données, pas d'administrateur de base de données : une base de données gérée, et un budget pour le multiplicateur plus l'offre de support. Un choix idéal pour une startup qui préfère livrer des fonctionnalités plutôt que bâtir une topologie de répliques.
Plusieurs applications partageant un même parc : un serveur de base de données par application quand c'est possible, des instances séparées plutôt que des schémas séparés dans une seule, pour qu'une requête emballée dans un produit ne prive pas les autres.
Charge de production stable avec quelqu'un pour l'exploiter : auto-hébergé sur un serveur dédié. Une machine avec une réplique coûte un montant fixe par mois, et le coût ne bouge pas quand vos données doublent. Notre comparatif serveur dédié et VPS situe cette ligne.
Conclusion
Il n'y a pas de meilleur serveur de base de données unique, seulement une solution qui s'adapte à votre modèle de données, vos requêtes et la personne d'astreinte à 3 h du matin. Chaque base de données de cette liste est une solution raisonnable pour une application et la mauvaise pour une autre.
PostgreSQL est le choix par défaut le plus sûr en 2026, et la réponse généraliste la plus robuste pour une nouvelle application. Les plateformes gérées valent leur multiplicateur quand votre équipe est petite. Et pour une charge stable avec quelqu'un pour l'exploiter, un serveur dédié vous donne la machine entière à prix fixe, la gamme Kimsufi démarrant à 9,99 €/mois avec accès root complet.
FAQ
Quel serveur de base de données est le meilleur ?
Cela dépend de la charge. Pour des applications transactionnelles, PostgreSQL ou MySQL. Pour de l'analytique à grande échelle, un entrepôt comme Redshift ou Snowflake. Pour des microservices à faible latence avec une structure souple, une plateforme document gérée comme MongoDB Atlas.
MongoDB est-il toujours pertinent en 2026 ?
Oui. MongoDB Atlas reste la référence du stockage document souple, avec sharding natif, cohérence configurable et un écosystème mature. La réserve est que le support JSON de PostgreSQL couvre désormais beaucoup de cas qui demandaient autrefois une base document séparée.
Entre MariaDB et MySQL, lequel est le plus rapide ?
Elles partagent un ancêtre commun, et la réponse honnête est que cela dépend de la charge et de la version. MariaDB ajoute des moteurs de stockage et du travail d'optimiseur qui peuvent aider les schémas à forte lecture ; MySQL a ses propres améliorations d'optimiseur. Benchmarkez les deux sur votre propre jeu de données plutôt que de faire confiance à un pourcentage publié.
Quelles sont les 5 meilleures bases de données ?
PostgreSQL, MySQL, Microsoft SQL Server, MongoDB et MariaDB couvrent la plupart des usages de production, avec un entrepôt de données à côté pour l'analytique. Chacune gagne ailleurs, c'est pourquoi la liste n'est pas un classement.